Contenido
- De prompt engineering a harness engineering
- Qué es el harness de un agente
- Las 7 capas del harness
- 1. Herramientas orquestadas
- 2. Verificación independiente
- 3. Contexto y memoria
- 4. Guardrails
- 5. Observabilidad
- 6. Enrutamiento de modelos
- 7. Feedback continuo
- Cómo viaja una petición por el harness
- Por qué el modelo ya no es la ventaja
- Cómo evaluar a un proveedor de agentes
- Por dónde empezar: los primeros 90 días
- Cómo trabajamos esto en Nivelics
- Preguntas frecuentes
- ¿Qué es harness engineering?
- ¿En qué se diferencia de prompt engineering y context engineering?
- ¿Si uso el mejor modelo del mercado necesito igual un harness?
- ¿Qué capa del harness conviene construir primero?
- ¿Cómo sé si un proveedor de agentes realmente construye harness?
- Fuentes
Si hoy comparas dos agentes de IA que usan el mismo modelo, uno puede resolver casos reales en tu ERP con trazabilidad completa y el otro puede inventar un número de factura y enviarlo a un cliente. El modelo es el mismo. La diferencia está en todo lo demás: qué herramientas puede invocar y con qué permisos, quién revisa lo que produce, qué información recibe, qué queda registrado y cómo se corrige cuando falla.
A ese "todo lo demás" se le empezó a llamar harness: el arnés o andamiaje que rodea al modelo. Y a la disciplina de diseñarlo, harness engineering. Los modelos de frontera tienden a converger y se reemplazan cada pocos meses; el harness es lo que convierte a cualquiera de ellos en un sistema en el que se puede confiar, y es lo que queda cuando cambias de modelo.
De prompt engineering a harness engineering
La forma en que los equipos técnicos trabajan con modelos de lenguaje ha cambiado de foco tres veces en pocos años.
Prompt engineering. La primera etapa se concentró en la redacción: cómo formular la instrucción, qué ejemplos incluir, cómo pedir un formato. Funcionaba para interacciones de una sola vuelta y producía resultados frágiles: un cambio de modelo o de redacción rompía lo que funcionaba.
Context engineering. Cuando los modelos empezaron a encadenar pasos y usar herramientas, el cuello de botella pasó de las palabras a la información. Anthropic lo definió en septiembre de 2025 como las estrategias para curar y mantener el conjunto óptimo de tokens durante la inferencia, incluida toda la información que llega al modelo además del prompt. La pregunta dejó de ser "¿cómo lo digo?" y pasó a ser "¿qué necesita saber el modelo en este paso y qué sobra?".
Harness engineering. A comienzos de 2026 el término ganó tracción. Mitchell Hashimoto, cofundador de HashiCorp, describió en su recuento de adopción de IA una práctica que llamó "engineer the harness": cada vez que un agente comete un error, dedicar tiempo a construir una solución para que ese error no vuelva a ocurrir. Días después, OpenAI publicó un informe sobre un experimento interno en el que ingenieros construyeron un producto con agentes de programación y se dedicaron a diseñar entornos, especificar intención y dar retroalimentación estructurada en lugar de escribir el código. Birgitta Böckeler, en el sitio de Martin Fowler, lo resumió como un conjunto de prácticas y herramientas para mantener a los agentes bajo control.
Esos textos nacieron con agentes de programación, pero la idea aplica igual a agentes de operaciones, finanzas, servicio o cumplimiento.
Qué es el harness de un agente
Una definición práctica: el harness es todo lo que rodea al modelo: quién le da herramientas, quién revisa su trabajo, qué recuerda, qué puede tocar y si alguien puede ver lo que hizo.
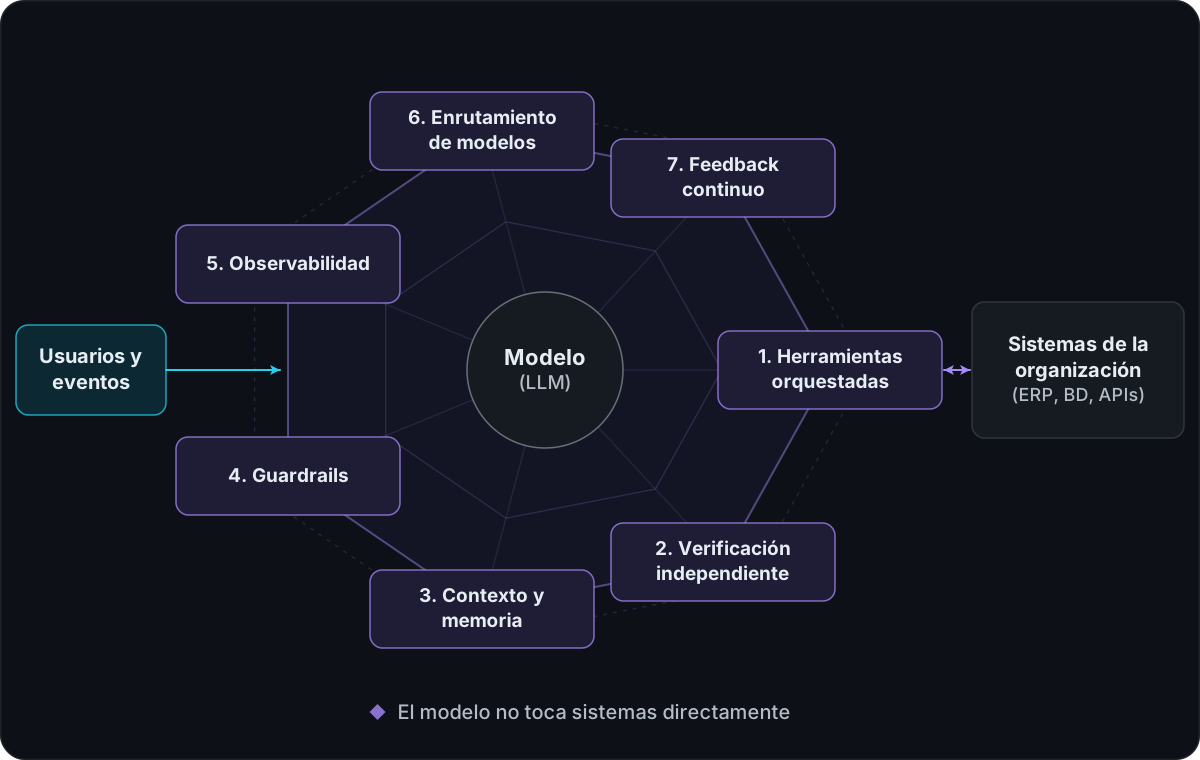
El modelo razona y propone; el harness decide qué se ejecuta, con qué datos, bajo qué límites y con qué registro. Consecuencia de arquitectura: el modelo nunca debería tener acceso directo a nada. Todo lo que sale de él es una propuesta que el harness valida.
Anthropic, en su guía Building effective agents, distingue entre workflows (modelos y herramientas orquestados por rutas de código predefinidas) y agentes (sistemas donde el modelo dirige dinámicamente su proceso y el uso de herramientas). Su recomendación es empezar con lo más simple posible y agregar autonomía solo cuando las soluciones simples no alcanzan. El harness es lo que permite subir la autonomía sin perder el control, porque hay capas que contienen el daño si el modelo se equivoca.
Las 7 capas del harness
Las capas son responsabilidades, no productos. Pueden vivir en un framework como LangGraph o el Vercel AI SDK, en servicios propios o en una plataforma como Amazon Bedrock o Azure OpenAI. Lo que importa es que cada una tenga un dueño técnico claro.
1. Herramientas orquestadas
Qué problema resuelve. Un agente es útil porque actúa: consulta un pedido, crea un ticket, actualiza un registro. Si el modelo tiene la credencial de una API y puede invocarla libremente, cualquier error de razonamiento o cualquier instrucción maliciosa que llegue en un documento se convierte en una acción real. OWASP clasifica esto como Excessive Agency (LLM06:2025) y señala tres causas: funcionalidad excesiva, permisos excesivos y autonomía excesiva.
Cómo se ve bien hecha. El modelo emite una intención de llamada ("quiero invocar consultar_pedido con estos argumentos"). Una capa intermedia valida los argumentos contra un esquema, comprueba que el usuario en nombre del cual actúa el agente tiene permiso sobre ese recurso, aplica límites de tasa y de volumen, ejecuta y registra. Las herramientas se diseñan para el agente, no como un espejo de la API existente: Anthropic advierte que un error común es crear herramientas que solo envuelven endpoints existentes, sin pensar si son adecuadas para un agente. Una herramienta buscar_cliente_por_nit que devuelve cinco campos relevantes es mejor que exponer el endpoint genérico del CRM con cuarenta. Si usas Model Context Protocol, la especificación exige que los servidores validen todas las entradas, implementen controles de acceso, limiten la tasa de invocaciones y saniticen las salidas.
Error típico. Darle al agente una cuenta de servicio con permisos de administrador "para no tener problemas en el piloto". El piloto pasa, nadie reduce los permisos y el agente llega a producción pudiendo hacer cualquier cosa.
Qué preguntarle a un proveedor. ¿Con qué identidad actúa el agente frente a cada sistema? ¿Dónde se valida que una llamada está autorizada: en el prompt o en código? ¿Qué herramientas son de solo lectura y cuáles escriben? ¿Hay un límite de acciones por ejecución?
2. Verificación independiente
Qué problema resuelve. Los modelos pueden afirmar que hicieron algo que no hicieron, o producir un resultado plausible pero incorrecto. Si el mismo componente que ejecuta la tarea es el que declara que salió bien, no tienes verificación: tienes autoevaluación.
Cómo se ve bien hecha. El principio es simple: quien verifica no es quien hace. Conviene combinar tres tipos de verificador: deterministas (código que comprueba que el total cuadra, que el registro existe, que el JSON cumple el esquema), basados en modelo (para lo que no se reduce a reglas, como la completitud de una respuesta; requieren calibración) y humanos (decisiones de alto impacto o muestras aleatorias). Anthropic describe el patrón evaluator-optimizer en su guía de agentes y, en su texto sobre evaluaciones de agentes, insiste en distinguir la transcripción (lo que el agente dijo que hizo) del resultado (el estado real del sistema al final). Un agente puede decir "tu reserva está confirmada"; la verificación mira si la reserva existe. Profundizamos en esto en evals y verificación de agentes.
Error típico. Usar el mismo modelo, con el mismo contexto, para generar y para revisar. Tiende a aprobar su propio trabajo. Otro error: tener evaluaciones solo antes del lanzamiento y ninguna en operación.
Qué preguntarle a un proveedor. ¿Qué se verifica de forma determinista y qué con otro modelo? ¿El verificador tiene acceso al estado real del sistema o solo a la respuesta del agente? ¿Cuántos casos tiene el conjunto de evaluación y quién los mantiene?
3. Contexto y memoria
Qué problema resuelve. El modelo solo sabe lo que está en su ventana de contexto en ese momento. Si le das demasiado, pierde precisión: Anthropic recoge la investigación sobre context rot, la caída de exactitud a medida que crece el contexto. Si le das muy poco, alucina lo que falta. Y si le das datos que el usuario no debería ver, tienes una fuga.
Cómo se ve bien hecha. El contexto se construye por paso, no se acumula. La meta, en palabras de Anthropic, es encontrar el conjunto más pequeño de tokens de alta señal que maximice la probabilidad del resultado deseado. En tareas largas se usan técnicas como la compactación (resumir el historial y reiniciar con lo esencial), notas estructuradas persistidas fuera de la ventana y subagentes con contexto limpio que devuelven resúmenes. La memoria de largo plazo tiene reglas explícitas: qué se guarda, por cuánto tiempo, quién puede leerla y cómo se borra. La recuperación de documentos (RAG) respeta los permisos del usuario que pregunta, no los de la cuenta del agente. Esto no es solo buena práctica: si procesas datos personales en Colombia, la Ley 1581 de 2012 establece, entre otros, los principios de finalidad y de acceso y circulación restringida.
Error típico. Indexar todo el repositorio documental sin filtros de permisos. El agente termina citando un documento de nómina en una respuesta a un proveedor.
Qué preguntarle a un proveedor. ¿Cómo decides qué entra al contexto en cada paso? ¿La recuperación filtra por los permisos del usuario final? ¿Qué persiste entre sesiones, dónde se almacena y cómo se ejerce el derecho de supresión?
4. Guardrails
Qué problema resuelve. Hay cosas que el agente no debe hacer nunca, sin importar lo que diga el usuario, un documento o una herramienta. Las instrucciones en el prompt no bastan: OWASP ubica la inyección de prompts como el primer riesgo de su Top 10 para aplicaciones LLM 2025, incluida la indirecta, que llega desde contenido externo como correos, páginas o archivos.
Cómo se ve bien hecha. Los guardrails se diseñan en cuatro frentes. De comportamiento: temas fuera de alcance, tono, negativas explícitas. De datos: detección y enmascaramiento de datos personales o secretos en entradas y salidas, y separación clara entre instrucciones y contenido externo no confiable. De herramientas: listas de acciones permitidas, umbrales (por ejemplo, un reembolso por encima de cierto valor requiere aprobación humana) y confirmación explícita para operaciones irreversibles. Operativos: límites de costo, de tiempo y de pasos por ejecución, y un interruptor para detener el agente. La regla que atraviesa todo: la autorización vive en los sistemas y en el código, no en la buena voluntad del modelo. OWASP lo llama complete mediation: implementar la autorización en los sistemas de destino en lugar de confiar en que el LLM decida si una acción está permitida. Lo desarrollamos en guardrails y control humano.
Error típico. Resolver la seguridad con una línea en el prompt del sistema ("nunca reveles información confidencial") y considerarlo un control.
Qué preguntarle a un proveedor. ¿Qué controles funcionan aunque el modelo sea engañado? ¿Qué acciones requieren aprobación humana y cómo se registra esa aprobación? ¿Se hizo red teaming con inyección indirecta a través de documentos y herramientas?
5. Observabilidad
Qué problema resuelve. Un agente es no determinista y cambia con el tiempo: cambia el modelo del proveedor, cambian los datos, cambian los usuarios. Sin telemetría, no sabes qué hizo, por qué, cuánto costó ni si hoy se comporta distinto que el mes pasado. Para un área de auditoría, un agente sin trazas es un agente que no se puede aprobar.
Cómo se ve bien hecha. Cada ejecución produce una traza completa: la entrada, cada llamada al modelo con su versión, cada invocación de herramienta con argumentos y resultado, cada decisión de los verificadores y guardrails, la salida, los tokens consumidos y la latencia. Conviene usar un estándar: OpenTelemetry mantiene convenciones semánticas para IA generativa, aún en estado de desarrollo, que incluyen operaciones como invoke_agent y execute_tool y convenciones específicas para MCP. Sobre esas trazas se definen métricas (resolución, escalamientos, reintentos) y alertas de drift: si los escalamientos suben tras una actualización del modelo, alguien se entera antes que el cliente. Más detalle en AgentOps y observabilidad de agentes en producción.
Error típico. Registrar solo la pregunta y la respuesta final. Cuando algo sale mal, no hay forma de saber en qué paso intermedio se torció.
Qué preguntarle a un proveedor. Muéstrame la traza completa de una ejecución real. ¿Cuánto tiempo se retienen y quién tiene acceso? ¿Qué alerta se dispara si el comportamiento cambia después de una actualización de modelo?
6. Enrutamiento de modelos
Qué problema resuelve. No todas las tareas necesitan el modelo más grande. Clasificar un correo, extraer campos de un formulario o redactar un análisis complejo tienen requisitos distintos de calidad, latencia, costo y, sobre todo, de dónde pueden procesarse los datos. Un solo modelo para todo es caro, lento o inadmisible para ciertos datos.
Cómo se ve bien hecha. Una capa de enrutamiento (routing) clasifica la petición y la dirige: a un modelo pequeño y rápido para tareas simples, a uno de frontera para razonamiento complejo, a un modelo abierto servido en tu infraestructura (Llama, Qwen o Mistral con vLLM u Ollama) cuando los datos no pueden salir, o a un flujo determinista cuando no hace falta un modelo. Anthropic describe el enrutamiento como uno de los patrones básicos de sistemas agénticos. Además da resiliencia ante la caída de un proveedor y aísla el resto del harness del modelo concreto: cambiar de modelo es un cambio de configuración validado con evals, no una reescritura. Si la soberanía de datos es un requisito, revisa IA privada y agentes on-premise.
Error típico. Acoplar prompts y parsers a un solo modelo. El día que ese modelo se retira o cambia de precio, el proyecto se reabre.
Qué preguntarle a un proveedor. ¿Qué pasa si mañana cambiamos de modelo? ¿Qué criterios deciden la ruta de cada petición? ¿Qué datos pueden ir a un modelo en nube y cuáles deben quedarse en infraestructura propia?
7. Feedback continuo
Qué problema resuelve. Un agente que no aprende de sus errores repite los mismos errores. La esencia de la idea de Hashimoto es exactamente esta: cada fallo se convierte en una mejora permanente del harness.
Cómo se ve bien hecha. Las señales llegan de varias fuentes: correcciones de usuarios, escalamientos, rechazos de los verificadores, casos marcados por auditoría. Cada caso relevante se analiza y se traduce en algo concreto: un nuevo caso en el conjunto de evaluación, una regla en un guardrail, una mejora en la descripción de una herramienta, un ajuste en qué contexto se entrega. Ningún cambio llega a producción sin pasar por las evals, que actúan como pruebas de regresión. Esto conecta con marcos de gobierno: el NIST AI RMF 1.0 organiza la gestión de riesgo en cuatro funciones (Govern, Map, Measure, Manage), y ISO/IEC 42001 exige mejora continua dentro de un sistema de gestión de IA.
Error típico. Cambiar el prompt en producción porque un usuario se quejó, sin evaluar el efecto en el resto de los casos. Se arregla uno y se rompen tres.
Qué preguntarle a un proveedor. ¿Cómo llega un error reportado por un usuario a convertirse en una prueba? ¿Qué evals corren antes de cada despliegue? ¿Quién aprueba los cambios de comportamiento del agente?
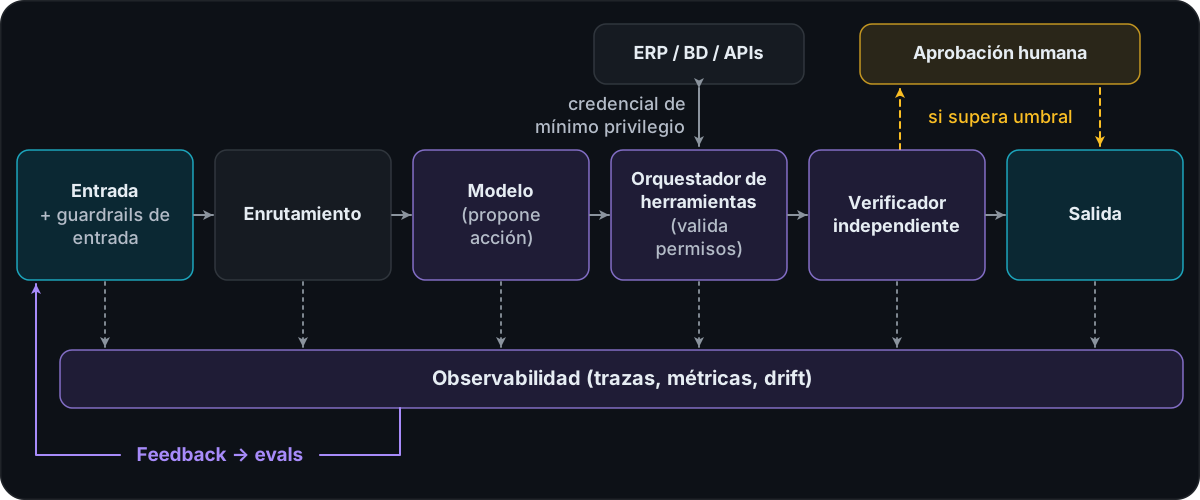
Cómo viaja una petición por el harness
Sigamos una petición concreta. Supón que un analista de cuentas por pagar pide: "¿Por qué no se ha pagado la factura del proveedor X?".
- Entrada: llega con la identidad del analista; los guardrails separan instrucciones de datos.
- Enrutamiento: se clasifica como consulta de estado y se envía al modelo adecuado.
- Modelo: con un contexto acotado a ese rol, propone llamar a
consultar_facturayconsultar_estado_aprobacion. - Orquestador: valida argumentos y permisos sobre ese proveedor, y ejecuta contra el ERP con credencial de solo lectura.
- Verificador: comprueba que la respuesta solo cita datos que devolvieron las herramientas.
- Salida: el analista recibe la respuesta. Una escritura por encima del umbral habría pasado por aprobación humana.
Cada paso emite trazas hacia observabilidad, y los casos marcados alimentan el ciclo de mejora.
Por qué el modelo ya no es la ventaja
Tres razones prácticas para mover la atención al harness.
Los modelos se vuelven intercambiables. Si tu ventaja depende de un modelo concreto, desaparece con el próximo lanzamiento de la competencia o con el retiro de esa versión.
El riesgo está fuera del modelo. A un comité de riesgo no le preocupa que el modelo razone mal en abstracto, sino que el agente pague una factura dos veces, exponga datos de un cliente o actúe sin dejar rastro. Eso se controla en el harness.
El conocimiento de tu operación vive en el harness. Las herramientas diseñadas para tus procesos, las evals construidas con tus excepciones y tus umbrales de aprobación son activos propios que se acumulan y no se compran con una suscripción.
Cómo evaluar a un proveedor de agentes
Usa esta lista con cualquier proveedor, interno o externo. En un piloto no todas las respuestas serán perfectas, pero todas deberían existir.
Arquitectura y acceso
- El modelo no tiene credenciales directas a ningún sistema; toda acción pasa por una capa que valida y registra.
- Cada herramienta tiene definido si es de lectura o escritura, su esquema de entrada y sus límites.
- El agente actúa con la identidad o los permisos del usuario final cuando corresponde, no con una cuenta de servicio omnipotente.
- Las integraciones siguen un estándar documentado (por ejemplo, MCP) o una capa de integración propia con contratos claros.
Verificación y calidad
- Existe un conjunto de evaluación con casos reales de tu operación, incluidos casos límite y adversarios.
- Las evals corren antes de cada cambio de prompt, herramienta o modelo.
- Hay verificación independiente de los resultados, no solo autoevaluación del agente.
Seguridad y cumplimiento
- Se probó inyección de prompts indirecta a través de documentos, correos y respuestas de herramientas.
- Las acciones de alto impacto requieren aprobación humana registrada.
- Está claro qué datos salen de tu infraestructura, hacia qué proveedor y en qué región.
- La recuperación de documentos respeta permisos por usuario.
Operación
- Puedes ver la traza completa de cualquier ejecución, con versión de modelo, herramientas invocadas y costo.
- Hay alertas de drift y un procedimiento para detener el agente.
- Hay un proceso documentado para convertir errores en mejoras verificadas.
- Cambiar de modelo es posible sin reescribir el sistema.
Señal de alerta: si la demo es impecable pero nadie puede mostrarte qué pasa cuando el agente se equivoca, viste un prompt bien escrito, no un sistema.
Por dónde empezar: los primeros 90 días
Días 1 a 30: elegir bien y preparar el terreno.
- Escoge un proceso acotado, frecuente y medible, con un dueño de negocio. Mejor si empieza en modo asistencia: el agente consulta y propone, un humano ejecuta.
- Mapea los sistemas que el agente necesita tocar. Aquí aparecen los sistemas sin API y los permisos mal definidos.
- Construye un primer conjunto de evaluación con casos reales, incluidos los difíciles. Sin esto no sabrás si el agente funciona.
- Define con riesgo y seguridad qué datos pueden procesarse, dónde y con qué modelo.
Días 31 a 60: construir el harness mínimo.
- Implementa las herramientas orquestadas con permisos mínimos y herramientas diseñadas para el agente.
- Instrumenta la observabilidad desde el primer día, no al final.
- Agrega verificación determinista donde sea posible y guardrails de datos y de herramientas.
- Corre el agente en sombra: procesa casos reales sin actuar y compara con lo que hizo el equipo humano.
Días 61 a 90: producción controlada.
- Libera a un grupo reducido de usuarios con aprobación humana en acciones sensibles.
- Revisa trazas semanalmente, convierte cada error relevante en un caso de evaluación y ajusta.
- Define los indicadores con los que se decidirá ampliar el alcance: calidad, tasa de escalamiento, tiempo de resolución.
- Documenta el harness como plataforma: el segundo agente debería reutilizar herramientas, observabilidad y evals del primero.
Si en el día 90 tienes un agente útil, trazable y con un ciclo de mejora funcionando, tienes algo más valioso que el agente: la base para construir los siguientes con menos riesgo.
Cómo trabajamos esto en Nivelics
En Nivelics construimos agentes pensando primero en el harness. Nuestro servicio de ingeniería de agentes a la medida cubre las siete capas; cuando el reto principal es conectar con sistemas existentes, trabajamos la integración de sistemas con MCP; cuando los datos no pueden salir de tu infraestructura, diseñamos IA privada on-premise con modelos abiertos; y para agentes que ya están en operación, ofrecemos operación y gobierno de agentes (AgentOps).
Cada capa de este artículo tiene su propia guía en profundidad: MCP para integrar agentes con sistemas legados, IA privada y agentes on-premise, evals y verificación de agentes, guardrails y control humano y AgentOps y observabilidad en producción.
Si estás evaluando llevar un agente a producción, o tienes uno en piloto que no termina de ganarse la confianza de riesgo y auditoría, conversemos. Revisamos contigo el caso, los sistemas involucrados y qué capas del harness necesitas primero.
Preguntas frecuentes
¿Qué es harness engineering?
Es la disciplina de diseñar todo lo que rodea al modelo de lenguaje en un agente: cómo accede a herramientas, quién verifica su trabajo, qué contexto y memoria recibe, qué límites tiene, cómo se observa y cómo mejora con el tiempo. El término ganó difusión a comienzos de 2026 a partir de textos de Mitchell Hashimoto y del equipo de OpenAI sobre agentes de programación, pero el concepto aplica a cualquier agente que opere en sistemas reales.
¿En qué se diferencia de prompt engineering y context engineering?
Prompt engineering optimiza las instrucciones de una interacción. Context engineering decide qué información entra en la ventana de contexto del modelo en cada paso. Harness engineering incluye a ambas, pero agrega lo que ocurre fuera del modelo: permisos, validación de acciones, verificación independiente, trazabilidad y ciclos de mejora.
¿Si uso el mejor modelo del mercado necesito igual un harness?
Sí. Un modelo más capaz reduce algunos errores, pero no decide qué sistemas puede tocar, no deja registro auditable de lo que hizo ni detecta que su comportamiento cambió después de una actualización. Esas garantías las da el harness, y son las que un área de riesgo o auditoría va a pedir antes de aprobar un agente en producción.
¿Qué capa del harness conviene construir primero?
Las herramientas orquestadas con permisos mínimos y la observabilidad. Sin la primera, el agente puede hacer más de lo que debería; sin la segunda, no sabes qué hizo. Verificación, guardrails y evals se montan sobre esa base.
¿Cómo sé si un proveedor de agentes realmente construye harness?
Pídele que te muestre, sobre un caso concreto, la traza completa de una ejecución, la lista de herramientas con sus permisos, el conjunto de evaluaciones que corre antes de cada cambio y qué pasa cuando el agente se equivoca. Si la respuesta se centra en el modelo o en el prompt, el harness probablemente no existe.
Fuentes
¿Quieres implementar IA en tu empresa?
Agenda un diagnóstico gratuito con nuestro equipo.
Hablar con un experto