Contenido
- Cuándo los datos no pueden salir de tu infraestructura
- Las tres rutas de despliegue
- 1. API pública con acuerdos de no entrenamiento
- 2. Nube en tu cuenta: Amazon Bedrock y Azure OpenAI
- 3. Modelos abiertos on-premise con vLLM u Ollama
- Tabla comparativa
- La respuesta suele ser híbrida: enrutamiento por sensibilidad del dato
- Qué exige operar modelos abiertos de verdad
- GPU y dimensionamiento
- Cuantización
- Evals propios
- Parches y ciclo de vida
- Checklist antes de comprometerte con on-premise
- Cumplimiento: lo que la arquitectura puede y no puede resolver
- Cómo lo abordamos
- Preguntas frecuentes
- ¿Usar la API de un proveedor de modelos significa que mis datos se usan para entrenar?
- ¿Qué diferencia hay entre usar Claude por API y usarlo en Amazon Bedrock?
- ¿Un modelo abierto on-premise es tan bueno como uno de frontera?
- ¿Desplegar on-premise me hace cumplir automáticamente la Ley 1581 de 2012?
- ¿Por dónde empiezo si quiero una arquitectura híbrida?
- Fuentes
La pregunta "¿qué modelo usamos?" suele llegar tarde. En organizaciones con datos de clientes, historias clínicas, información financiera o secretos industriales, la pregunta que decide la arquitectura es otra: ¿por dónde puede viajar cada dato y quién puede verlo mientras el agente lo procesa? Un chatbot que responde preguntas frecuentes puede vivir tranquilo detrás de una API pública. Un agente que lee contratos, consulta el ERP y redacta respuestas con datos personales no.
Veremos las tres rutas de despliegue (API pública, nube en tu cuenta y on-premise), cómo compararlas, por qué la respuesta casi siempre es un híbrido que las combina y qué implica operar modelos abiertos en tu propio centro de datos. Es una pieza del harness de un agente: la capa de enrutamiento de modelos (routing), cruzada con los guardrails de datos.
Cuándo los datos no pueden salir de tu infraestructura
Conviene separar la "soberanía de datos" en restricciones concretas, porque cada una empuja la arquitectura hacia un lado distinto:
- Restricción contractual. Un cliente o socio te prohíbe por contrato procesar su información con terceros, o exige saber exactamente qué subencargados tocan sus datos.
- Restricción regulatoria. La norma aplicable limita transferencias internacionales o exige medidas de seguridad específicas. En Colombia, la Ley 1581 de 2012 prohíbe en su artículo 26 transferir datos personales a países que no ofrezcan niveles adecuados de protección según los estándares de la Superintendencia de Industria y Comercio (con excepciones que tu equipo legal debe revisar).
- Restricción de riesgo. No hay norma que lo impida, pero la información es tan sensible (propiedad intelectual, estrategia, datos de seguridad) que la organización no acepta ese riesgo residual.
- Restricción de conectividad. Plantas, sedes remotas o redes segmentadas donde el agente debe funcionar aunque no haya salida a internet.
Si ninguna aplica, forzar on-premise es gastar dinero y calidad sin necesidad. Si alguna aplica, el despliegue deja de ser preferencia y se vuelve requisito.
Las tres rutas de despliegue
1. API pública con acuerdos de no entrenamiento
Consumes el modelo directamente desde el proveedor (Anthropic, OpenAI, Google) por internet. Es la ruta con mejor calidad disponible el primer día y menor fricción operativa.
Lo que suele preocupar —que tus datos entrenen el modelo— se resuelve en los términos comerciales. Anthropic, por ejemplo, declara que por defecto no usa las entradas ni salidas de sus productos comerciales, incluida la API, para entrenar sus modelos.
Pero "no entrenar" no significa "no salir". El prompt, el contexto y las respuestas se procesan en la infraestructura del proveedor y pueden retenerse un tiempo para detectar abuso, según los términos del servicio. Para muchos casos es aceptable; para otros, es justo lo que el contrato o la norma prohíben.
2. Nube en tu cuenta: Amazon Bedrock y Azure OpenAI
El modelo de frontera lo sirve tu proveedor de nube y lo consumes desde tu cuenta, con tus controles de red, identidad y auditoría.
En Amazon Bedrock, la documentación de protección de datos explica que los modelos se despliegan en cuentas operadas por el equipo de Bedrock a las que los proveedores de modelos no tienen acceso: no ven los prompts ni las respuestas de los clientes. Puedes conectar tu VPC a Bedrock con AWS PrivateLink para que el tráfico no pase por internet, y registrar la actividad con CloudTrail. La retención de datos se configura por región y cada modelo declara qué modos admite; algunos exigen retener entradas y salidas dentro de AWS para revisión de abuso, y si tu política es de retención cero, esos modelos quedan no disponibles, salvo que solicites acceso con retención cero, que AWS evalúa por cuenta y por modelo. Revísalo antes de comprometerte.
En Azure OpenAI (hoy dentro de Microsoft Foundry), la documentación de privacidad establece que los prompts y respuestas no están disponibles para OpenAI ni para otros clientes, y no se usan para entrenar modelos base. También hay un sistema de monitoreo de abuso que puede almacenar muestras para revisión humana, salvo que tu organización sea aprobada para la modalidad modificada.
El valor de esta ruta: calidad de frontera en un perímetro que tu equipo de seguridad ya sabe auditar. El límite: el dato sale de tu centro de datos y se procesa en la región del proveedor de nube, y eso solo se cumple con despliegues regionales, sin inferencia global ni entre regiones. En Azure, los despliegues Global y DataZone pueden procesar fuera de la región elegida; en Bedrock, con la inferencia entre regiones los datos retenidos se guardan en la región de destino. Todo debe encajar con tus reglas de transferencia internacional.
3. Modelos abiertos on-premise con vLLM u Ollama
Descargas los pesos de un modelo abierto (familias como Llama, Qwen o Mistral) y lo sirves en tu propio hardware. El dato nunca sale de tu red.
Las dos herramientas más comunes cumplen roles distintos:
- vLLM es un motor de inferencia para producción: gestiona la memoria de atención con PagedAttention, expone un servidor compatible con la API de OpenAI, soporta cuantización y reparte el modelo entre varias GPU. Es la opción para muchos usuarios o agentes concurrentes.
- Ollama simplifica descargar y correr modelos localmente, con una API REST propia y compatibilidad con un subconjunto de la API de OpenAI. Es excelente para prototipos y despliegues pequeños; para cargas concurrentes altas, mejor vLLM.
La compatibilidad con la API de OpenAI importa: el mismo código del agente puede hablar con la nube o con tu servidor local cambiando solo el endpoint, lo que hace viable la arquitectura híbrida.
Tabla comparativa
Los valores son cualitativos a propósito: el costo real depende de volumen, tamaño de modelo, utilización del hardware y precios negociados.
| Criterio | API pública (no entrenamiento) | Nube en tu cuenta (Bedrock / Azure OpenAI) | Modelos abiertos on-premise (vLLM / Ollama) |
|---|---|---|---|
| Control de datos | Bajo: el dato se procesa en la infraestructura del proveedor del modelo | Medio-alto: consumido desde tu cuenta, con tus controles de red e identidad, en la región del proveedor (si el despliegue es regional) | Máximo: el dato no sale de tu red |
| Calidad del modelo | Frontera, con acceso inmediato a versiones nuevas | Frontera, con posible retraso en disponibilidad por región | Buena en tareas acotadas; brecha visible en razonamiento complejo y uso de herramientas |
| Costo operativo | Variable por uso, sin inversión inicial | Variable por uso, más costos de red y plataforma | Alto costo fijo (GPU, energía, personal); marginal bajo si la utilización es alta |
| Esfuerzo de operación | Bajo | Bajo-medio: IAM, redes, cuotas, retención | Alto: hardware, serving, actualizaciones, evals, seguridad |
| Latencia | Depende de internet y de la carga del proveedor | Buena si el modelo está en una región cercana | Baja en red local si el hardware está bien dimensionado |
La respuesta suele ser híbrida: enrutamiento por sensibilidad del dato
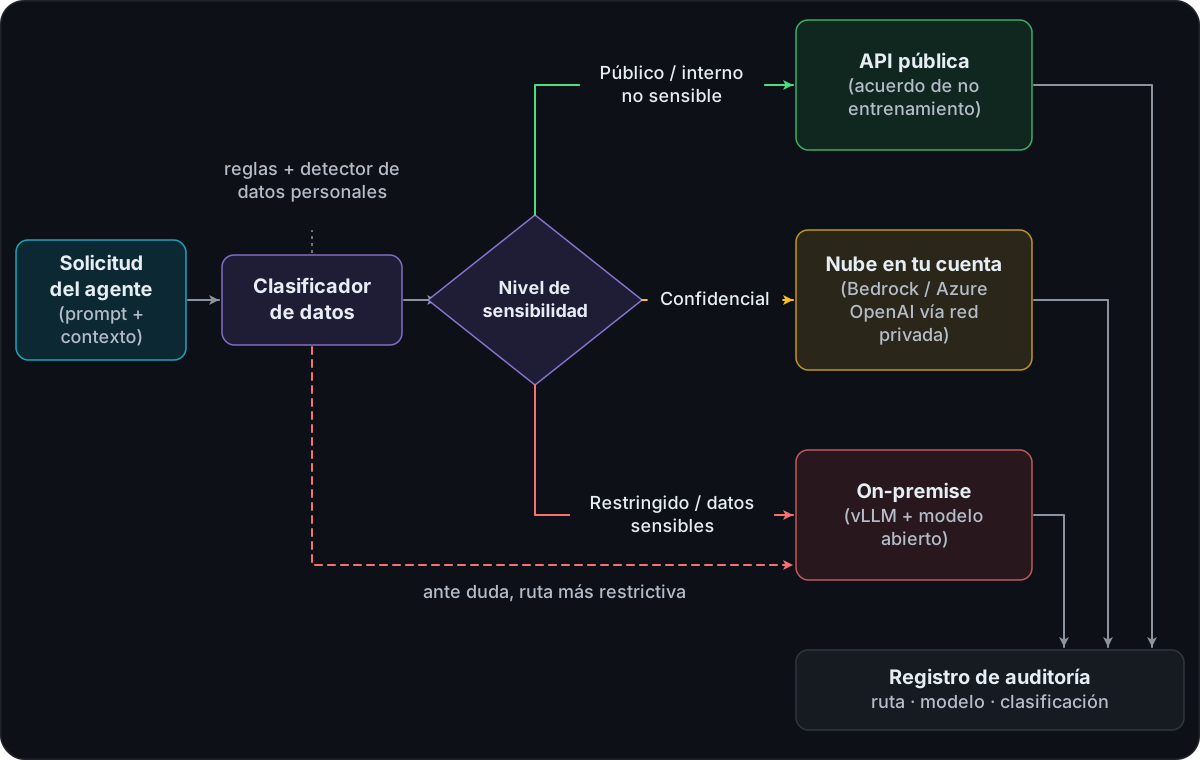
El híbrido no es una cuarta ruta: es la combinación de las tres. Pocas organizaciones tienen un único tipo de dato. El mismo agente de atención puede resolver una pregunta sobre horarios (dato público), consultar el estado de un pedido (dato interno) y leer una incapacidad médica adjunta (dato sensible en los términos del artículo 5 de la Ley 1581, que incluye, entre otros, los datos relativos a la salud). Mandar todo a on-premise sacrifica calidad donde no hace falta; mandar todo a la API pública viola la restricción en el caso sensible.
El patrón que funciona es un gateway de modelos que decide la ruta por clasificación del dato antes de cada llamada:
Cuatro reglas de diseño que evitan los errores más comunes:
- La clasificación la hace código, no el modelo. Un clasificador determinista (etiquetas de origen del documento, reglas por campo, detectores de identificadores personales) decide la ruta. Pedirle al LLM que decida si un dato es sensible es enviarle el dato sensible para que lo decida.
- Ante la duda, la ruta más restrictiva. Si el clasificador no puede determinar el nivel, el dato va a on-premise. El error barato es perder algo de calidad; el caro es una fuga.
- La clasificación viaja con el contexto. Si el agente recupera un documento restringido en mitad de una conversación, toda la conversación sube de nivel. Los niveles solo suben, nunca bajan dentro de una sesión.
- Cada decisión queda registrada. Qué ruta, qué modelo, qué clasificación y por qué. Sin ese registro no hay auditoría posible, y es la base de la operación y gobierno de agentes.
Qué exige operar modelos abiertos de verdad
Ir on-premise suele decidirse pensando en el modelo y subestimando todo lo demás. Esto es lo que vas a operar:
GPU y dimensionamiento
El cuello de botella es la memoria de la GPU: los pesos del modelo más el caché de atención de cada solicitud concurrente, que crece con la longitud del contexto. Dimensiona con cargas reales (tamaño de contexto típico, concurrencia en hora pico, latencia objetivo) y no con la ficha técnica del modelo.
Cuantización
Como resume la documentación de vLLM, la cuantización sacrifica precisión del modelo a cambio de menos memoria, lo que permite correr modelos grandes en más tipos de hardware. Pero la pérdida no es uniforme: puede ser imperceptible en resumen y notable en seguimiento de instrucciones estrictas o en generación de llamadas a herramientas con formato exacto. La única forma de saber si una versión cuantizada sirve para tu agente es medirla.
Evals propios
Con un modelo abierto no hay nadie más midiendo la calidad por ti en tu caso de uso. Necesitas un conjunto de pruebas propio —tareas reales, respuestas esperadas, llamadas a herramientas correctas— que corras antes de cambiar de modelo, de cuantización o de versión del servidor de inferencia. Más en evals y verificación de agentes. Sin esto, cada actualización es una apuesta.
Parches y ciclo de vida
Asumes el ciclo de vida completo: parches del servidor de inferencia y sus dependencias, drivers de GPU, nuevas versiones del modelo (a evaluar antes de adoptar), control de acceso y monitoreo. Un endpoint de inferencia sin autenticación en la red corporativa es una superficie de ataque real.
Checklist antes de comprometerte con on-premise
- ¿Hay una restricción concreta (contractual, regulatoria, de riesgo o de conectividad) que lo justifique para este caso de uso?
- ¿Mediste un modelo abierto candidato contra tus tareas reales, incluida su versión cuantizada?
- ¿Tienes estimada la concurrencia y el tamaño de contexto en hora pico?
- ¿Quién opera el servidor de inferencia, los drivers y los parches, y con qué acuerdo de servicio?
- ¿El endpoint está autenticado, segmentado y registrado?
- ¿El código del agente puede cambiar de ruta (local o nube) sin reescribirse?
Cumplimiento: lo que la arquitectura puede y no puede resolver
Esto no es asesoría legal, y ninguna decisión de despliegue reemplaza el análisis de tu área jurídica o de protección de datos.
Ley 1581 de 2012 (Colombia). Establece principios para el tratamiento de datos personales —entre ellos finalidad, circulación restringida, seguridad y confidencialidad— y restringe la transferencia internacional a países con niveles adecuados de protección. La arquitectura aporta evidencia a varios de esos principios: la ruta on-premise o una región elegida con cuidado ayudan con la transferencia internacional; el registro de auditoría ayuda con seguridad y circulación restringida. Pero la autorización del titular, la finalidad del tratamiento y el papel del proveedor de nube como encargado son preguntas legales, no técnicas.
ISO/IEC 42001. Es la norma internacional para sistemas de gestión de IA. No te dice dónde desplegar el modelo; te pide que gestiones riesgos, evalúes impacto, supervises proveedores y midas desempeño de forma sistemática. Una arquitectura con clasificación explícita, enrutamiento registrado y evals periódicos produce exactamente el tipo de evidencia que ese sistema de gestión necesita. Lo mismo aplica al NIST AI RMF.
Diseña para que el cumplimiento sea demostrable: si un auditor pregunta por qué una conversación con datos de salud se procesó donde se procesó, la respuesta debe estar en un log, no en la memoria de un ingeniero.
Cómo lo abordamos
En Nivelics diseñamos arquitecturas de IA privada y on-premise empezando por la clasificación de datos y los requisitos de cumplimiento, y solo después elegimos modelos y ruta de despliegue: Claude en Amazon Bedrock o modelos de Azure OpenAI consumidos desde tu cuenta, modelos abiertos servidos con vLLM en tu infraestructura, o la combinación de esas rutas detrás de un gateway con enrutamiento por sensibilidad y evals que validan cada ruta.
Si estás evaluando dónde puede correr un agente con datos que no pueden salir de tu organización, conversemos: revisamos tus restricciones reales y te proponemos una arquitectura que puedas defender ante tu comité de riesgo.
Preguntas frecuentes
¿Usar la API de un proveedor de modelos significa que mis datos se usan para entrenar?
No necesariamente. Anthropic, por ejemplo, declara que por defecto no usa las entradas ni salidas de sus productos comerciales, incluida la API, para entrenar modelos. Aun así, 'no entrenar' no equivale a 'no salir de tu infraestructura': el dato viaja y se procesa fuera, y puede retenerse temporalmente para monitoreo de abuso según los términos de cada servicio.
¿Qué diferencia hay entre usar Claude por API y usarlo en Amazon Bedrock?
En Bedrock el modelo corre en cuentas operadas por AWS a las que el proveedor del modelo no tiene acceso, y tu tráfico puede ir por AWS PrivateLink desde tu VPC. Ganas controles de red, identidad (IAM), registro con CloudTrail y configuración de retención por región. El modelo es el mismo; lo que cambia es el perímetro contractual y técnico en el que se procesa.
¿Un modelo abierto on-premise es tan bueno como uno de frontera?
Para tareas acotadas y bien especificadas (clasificación, extracción, resumen de documentos internos, preguntas sobre una base de conocimiento), un modelo abierto bien elegido suele ser suficiente. En razonamiento de varios pasos y uso complejo de herramientas, la brecha suele notarse. La única forma honesta de saberlo es medirlo con tus propios evals sobre tus propias tareas.
¿Desplegar on-premise me hace cumplir automáticamente la Ley 1581 de 2012?
No. Dónde corre el modelo es una sola pieza; la ley exige, entre otras cosas, autorización del titular, finalidad legítima, medidas de seguridad y reglas para transferir datos fuera del país. La arquitectura puede facilitar el cumplimiento, pero la evaluación la debe hacer tu equipo legal o de protección de datos.
¿Por dónde empiezo si quiero una arquitectura híbrida?
Por la clasificación de datos, no por el modelo. Define tres o cuatro niveles de sensibilidad, decide qué ruta de despliegue admite cada nivel y pon un gateway que haga cumplir esa regla antes de cada llamada. Después eliges modelos por ruta y los validas con evals.
Fuentes
¿Quieres implementar IA en tu empresa?
Agenda un diagnóstico gratuito con nuestro equipo.
Hablar con un experto