Contenido
- Por qué un agente no se puede auto-evaluar
- Tipos de evals
- Conjuntos dorados: tu especificación ejecutable
- Evals de regresión en CI: nada cambia sin pasar por aquí
- Verificación en línea: un verificador antes de cada acción con efecto
- Métricas que importan
- Errores típicos
- Cómo lo abordamos
- Preguntas frecuentes
- ¿Por qué no basta con pedirle al agente que revise su propia respuesta?
- ¿Qué es un conjunto dorado (golden set)?
- ¿Se puede confiar en un LLM como juez?
- ¿Cuándo debe intervenir un humano?
- ¿Qué métricas debería ver un comité directivo?
- Fuentes
En el software tradicional nadie aprueba su propio pull request. Hay pruebas automáticas, revisión de pares y un pipeline que bloquea el despliegue si algo se rompe. Con los agentes de IA, muchas organizaciones olvidan esa disciplina justo cuando más la necesitan: el mismo modelo genera la respuesta, decide que está bien y ejecuta la acción. Funciona en la demo y falla en producción de formas difíciles de detectar.
La regla que proponemos es simple de enunciar y exigente de implementar: quien verifica no es quien hace. Es la capa de verificación independiente, una de las siete del harness de un agente, y probablemente la que más separa un piloto vistoso de un sistema en el que una organización regulada puede confiar. Este artículo explica por qué el agente no puede evaluarse a sí mismo, qué tipos de evals existen, cómo meterlos en tu ciclo de desarrollo y cómo poner un verificador en línea antes de cada acción con efecto.
Por qué un agente no se puede auto-evaluar
La intuición de "pídele que revise su respuesta" es razonable, pero la evidencia no la respalda. El trabajo Large Language Models Cannot Self-Correct Reasoning Yet (ICLR 2024) encontró que los modelos tienen dificultades para corregir su razonamiento sin retroalimentación externa, y que en ocasiones su desempeño empeora después de intentarlo. El modelo que se equivocó comparte, al revisar, los mismos puntos ciegos que lo llevaron al error.
Hay un segundo problema: cuando un modelo juzga, tiende a favorecerse. El estudio Judging LLM-as-a-Judge documentó en los jueces LLM sesgos de posición, de verbosidad y de autopromoción (preferir respuestas generadas por el propio modelo). Un agente que se califica a sí mismo junta los dos defectos.
Lo que sí funciona es introducir una señal independiente. La guía de Anthropic Building effective agents insiste en que los agentes necesitan obtener "verdad de terreno" del entorno en cada paso —resultados de herramientas, ejecución de código— y describe el patrón evaluador-optimizador, en el que una llamada genera y otra evalúa y retroalimenta en un ciclo. La clave está en que el evaluador tenga información o criterio que el generador no tiene.
Tipos de evals
No hay un tipo de eval mejor que los demás; hay uno adecuado para cada pregunta. La guía de Anthropic Demystifying evals for AI agents los resume en calificadores basados en código, basados en modelo y humanos, con ventajas y costos distintos. En la práctica conviene separar el primer grupo en dos:
| Tipo | Qué verifica | Fortalezas | Debilidades | Úsalo para |
|---|---|---|---|---|
| Determinista | Resultado exacto o estado del sistema: el registro existe, el test pasa, el JSON valida contra el esquema | Rápido, barato, reproducible | Rígido ante variaciones válidas | Llamadas a herramientas, formatos, efectos en sistemas |
| Basado en reglas | Condiciones de negocio: montos bajo el umbral, campos obligatorios, ausencia de datos prohibidos | Explicable, auditable | Solo cubre lo que alguien anticipó | Políticas, cumplimiento, guardrails |
| LLM-as-judge con rúbrica | Calidad abierta: tono, completitud, fidelidad a la fuente | Flexible, escala, capta matices | No determinista, más costoso, requiere calibración | Redacción, resúmenes, respuestas a clientes |
| Humano | Juicio experto del negocio | El estándar de referencia | Lento y caro | Calibrar a los demás, casos ambiguos, auditoría por muestreo |
Tres principios que cambian la calidad de tus evals:
- Califica el resultado, no el camino. Como señala la misma guía, suele ser mejor evaluar lo que el agente produjo y no la ruta que siguió, para no castigar soluciones alternativas válidas. Si el agente de soporte debía emitir un reembolso, verifica que el reembolso exista con el monto correcto en el sistema, no que haya llamado a las herramientas en el orden que imaginaste.
- Un juez LLM necesita rúbrica y calibración. La rúbrica debe ser concreta ("¿cita el número de caso? ¿promete plazos que no están en la política?"), no "califica la calidad de 1 a 10". Y sus notas deben compararse periódicamente con las de expertos humanos; si divergen, el juez está mal configurado.
- Juez y generador, distintos. Otro modelo, u otro proveedor, o al menos otro prompt con otra información. Si usas el mismo modelo con el mismo contexto, vuelves al problema de la autoevaluación.
Conjuntos dorados: tu especificación ejecutable
Un conjunto dorado (golden set) es una colección de tareas representativas con su resultado esperado, validada por quienes conocen el negocio. Es, en la práctica, la especificación del agente escrita de forma que una máquina pueda comprobarla.
Cómo construirlo sin convertirlo en un proyecto eterno:
- Empieza con fallas reales. Anthropic sugiere arrancar con 20 a 50 tareas sencillas tomadas de fallas reales. Es suficiente para detectar retrocesos y te obliga a mirar lo que de verdad sale mal.
- Cubre las categorías, no solo el caso feliz. Solicitudes ambiguas, datos faltantes, intentos de manipulación en el texto de entrada, casos que deben escalarse, casos en los que la respuesta correcta es "no puedo hacer eso".
- Guarda la traza completa. Entrada, contexto recuperado, llamadas a herramientas, salida. Cuando una prueba falla, necesitas ver dónde se torció.
- Cada incidente en producción agrega un caso. El conjunto crece con el uso y es mucho menos probable tropezar dos veces con la misma piedra sin enterarte.
- Tiene dueño y versión. Si nadie del negocio lo revisa, se desactualiza con las políticas y empieza a premiar respuestas que ya no son correctas.
Evals de regresión en CI: nada cambia sin pasar por aquí
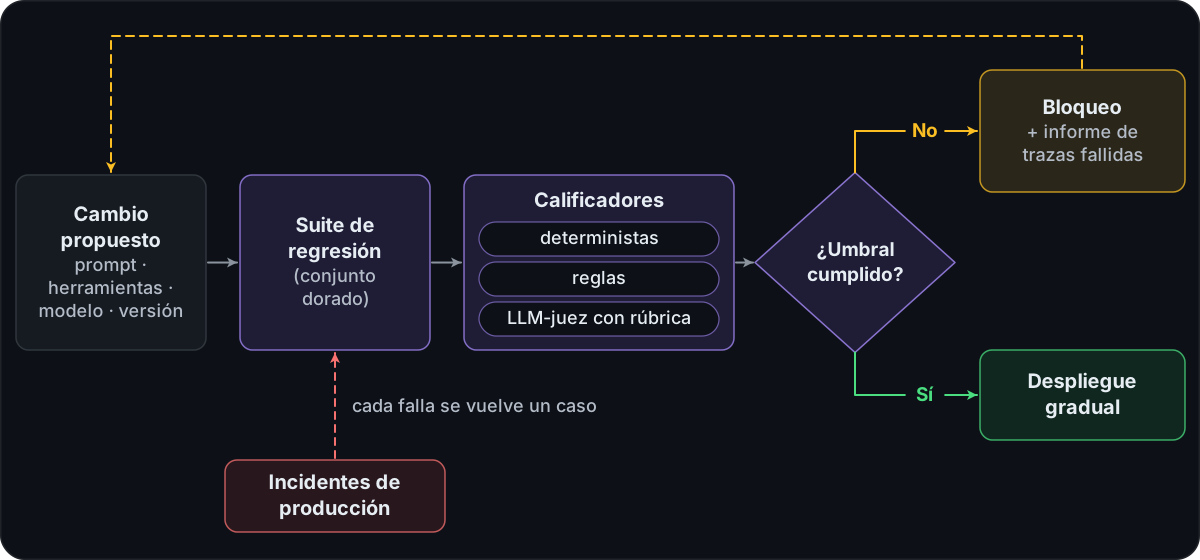
En un agente, "el código" incluye el prompt del sistema, las descripciones de herramientas, la configuración de recuperación de contexto y el modelo mismo. Cambiar cualquiera de ellos puede romper comportamientos que funcionaban. Por eso los evals deben correr en tu pipeline de integración continua, igual que las pruebas unitarias.
La guía de Anthropic distingue dos suites con propósitos distintos: los evals de capacidad, que arrancan con una tasa de aprobación baja porque apuntan a lo que el agente todavía no hace bien, y los evals de regresión, que deben mantenerse cerca del 100 % y protegen contra retrocesos. Mezclarlas genera ruido: no sabes si bajó la nota porque empeoraste o porque agregaste casos difíciles.
Detalles que marcan la diferencia:
- Corre varias veces cada tarea. Los agentes no son deterministas. La guía de Anthropic diferencia pass@k (probabilidad de al menos un éxito en k intentos) de pass^k (probabilidad de que los k intentos tengan éxito). Para un agente que atiende clientes, lo que importa es la consistencia: pass^k.
- Umbrales explícitos por categoría. Un cambio que mejora la redacción pero baja la precisión en herramientas no debería pasar. Define qué métricas bloquean y cuáles solo informan.
- Lee las trazas. Es una recomendación que repite la guía de Anthropic sobre evals: revisa las transcripciones de las pruebas fallidas y de una muestra de las aprobadas. Es la forma de descubrir que el calificador está premiando algo equivocado.
- Cambio de modelo = release completo. Actualizar la versión del modelo, o cambiar de proveedor, es el cambio con más riesgo de regresión silenciosa. Trátalo como tal.
Verificación en línea: un verificador antes de cada acción con efecto
Los evals offline te dicen si el agente es bueno en promedio. No te protegen de la acción equivocada concreta que va a ejecutar ahora. Para eso necesitas verificación en línea: un componente independiente que revisa la acción propuesta antes de que toque un sistema real.
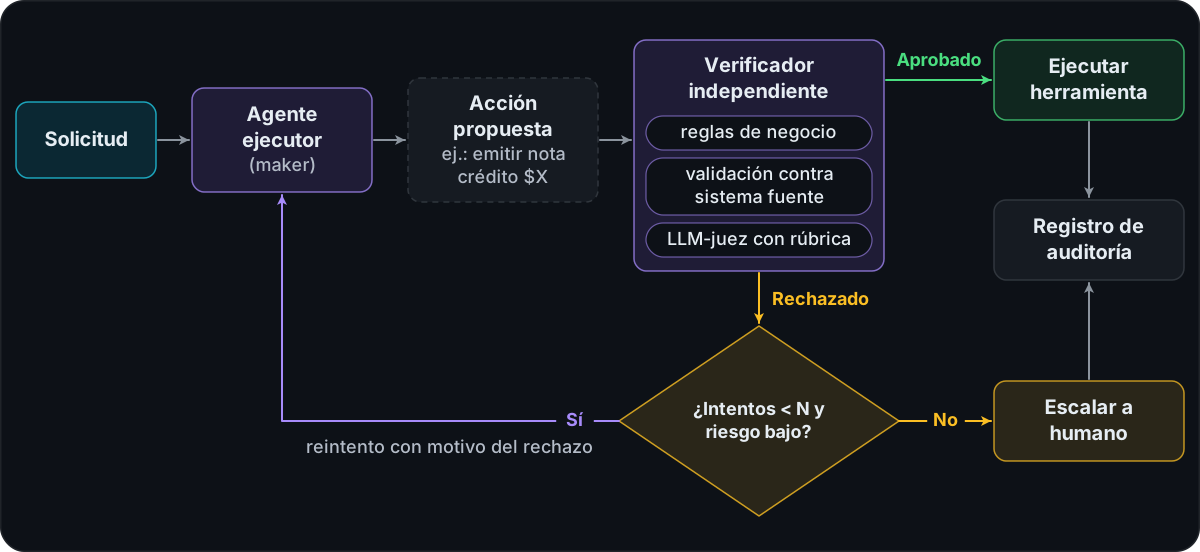
Cómo diseñar el verificador:
- Ordena los controles de barato a caro. Primero reglas deterministas (¿el monto supera el umbral autorizado? ¿el cliente existe? ¿el formato es válido?). Solo si pasan, un LLM-juez para lo que las reglas no cubren. Así la mayoría de rechazos cuesta milisegundos.
- Valida contra la fuente, no contra el relato del agente. Si el agente dice que la factura está duplicada, el verificador consulta el ERP. El verificador no confía en el razonamiento del ejecutor; confía en los sistemas.
- La autorización vive fuera del modelo. OWASP, en su riesgo LLM06:2025 Excessive Agency, recomienda implementar la autorización en los sistemas de destino en lugar de dejar que el LLM decida si una acción está permitida, y exigir aprobación humana para acciones de alto impacto.
- Rechazos con motivo. El reintento solo sirve si el ejecutor recibe una razón concreta ("el monto excede el tope autorizado por la política"). Un "rechazado" sin más produce el mismo error con otras palabras.
- Límite de reintentos. Después de N rechazos, o si la acción es de alto impacto, el caso va a una persona. Profundizamos en ese diseño en guardrails y control humano.
No todas las acciones merecen el mismo rigor. Leer un catálogo no necesita verificador; emitir un pago sí. Clasifica las herramientas por impacto y reversibilidad, y aplica verificación proporcional.
Métricas que importan
Muchas métricas de agentes miden actividad, no resultados. Estas tres dan una lectura honesta y son comprensibles fuera del equipo técnico:
| Métrica | Qué mide | Cómo se calcula | Señal de alarma |
|---|---|---|---|
| Tasa de éxito de tarea | Si el agente resolvió el caso de punta a punta | Tareas con resultado correcto verificado / tareas totales | Sube el volumen pero no la tasa de éxito |
| Precisión de herramientas | Si llamó a la herramienta correcta con parámetros correctos | Llamadas válidas y necesarias / llamadas totales | Muchas llamadas redundantes o rechazadas por el verificador |
| Tasa de escalamiento a humano | Cuánto trabajo humano sigue necesitando | Casos escalados / casos totales | Cae de golpe sin que suba la tasa de éxito (el agente dejó de escalar lo que debía) |
Súmales la tasa de rechazo del verificador como indicador temprano: si crece, algo cambió en las entradas, en los sistemas o en el modelo antes de que lo note un cliente. Estas métricas son la base de la operación y gobierno de agentes y encajan con la función de medir del NIST AI RMF.
Errores típicos
- Evaluar solo el caso feliz. El conjunto de pruebas lo escribió quien diseñó el agente, con los ejemplos que sabe que funcionan.
- Juez sin rúbrica. "¿Es buena esta respuesta?" produce notas que no significan nada y que cambian entre corridas.
- Mismo modelo como juez y ejecutor, con el mismo contexto. Es autoevaluación con pasos extra.
- Medir una sola corrida. Como ejemplo ilustrativo: un 90 % en una corrida puede ser un 60 % de consistencia real.
- Evals que nadie lee. El pipeline pasa en verde durante meses porque el calificador aprueba todo. Revisa trazas.
- Conjunto dorado congelado. Las políticas cambian; si las respuestas esperadas no, el agente aprende a cumplir reglas viejas.
- Verificar el texto y no el efecto. El agente dice "reembolso emitido", pero nadie comprueba que el reembolso exista en el sistema.
- Sin límite de reintentos. El ciclo maker-verifier sin tope se convierte en un bucle caro que no converge.
Cómo lo abordamos
En Nivelics, la verificación forma parte de la ingeniería de agentes a la medida desde el primer sprint: definimos con el negocio el conjunto dorado, separamos ejecutor y verificador, conectamos los evals al pipeline de CI y dejamos las métricas visibles para quienes deben responder por el agente. Trabajamos con Claude, modelos en Amazon Bedrock o Azure OpenAI y modelos abiertos, y orquestamos con herramientas como LangGraph o Vercel AI SDK según el caso.
Si tienes un agente que funciona en la demo pero no te atreves a dejarlo actuar solo, hablemos: empezamos por medir dónde falla hoy.
Preguntas frecuentes
¿Por qué no basta con pedirle al agente que revise su propia respuesta?
Porque comparte los mismos puntos ciegos que lo llevaron al error. La investigación sobre autocorrección muestra que, sin retroalimentación externa, los modelos tienen dificultades para corregir su razonamiento y a veces empeoran tras intentarlo. La verificación útil necesita una señal independiente: un test, una regla, otro evaluador o una persona.
¿Qué es un conjunto dorado (golden set)?
Es una colección de tareas representativas con su resultado esperado, revisada por expertos del negocio, contra la que se mide el agente cada vez que algo cambia. Conviene empezar pequeño, con casos tomados de fallas reales, e ir ampliándolo con cada incidente en producción.
¿Se puede confiar en un LLM como juez?
Sí, con condiciones: una rúbrica explícita, un modelo o configuración distinta al que generó la respuesta y calibración periódica contra evaluadores humanos. Los jueces LLM tienen sesgos documentados, como preferir la primera opción presentada, las respuestas largas o las generadas por ellos mismos.
¿Cuándo debe intervenir un humano?
Cuando la acción tiene efecto alto o irreversible (pagos, cambios contractuales, comunicaciones externas sensibles), cuando el verificador rechaza varias veces seguidas o cuando la confianza es baja. OWASP recomienda exigir aprobación humana para acciones de alto impacto en sistemas basados en LLM.
¿Qué métricas debería ver un comité directivo?
Tres bastan para empezar: tasa de éxito de tarea de punta a punta, precisión en el uso de herramientas y tasa de escalamiento a humano. Juntas muestran si el agente resuelve, si lo hace de forma segura y cuánto trabajo humano sigue necesitando.
Fuentes
¿Quieres implementar IA en tu empresa?
Agenda un diagnóstico gratuito con nuestro equipo.
Hablar con un experto