Contenido
- Qué observar en un agente
- OpenTelemetry para IA generativa: qué hay y en qué estado está
- Detección de drift: cuando el agente cambia sin que tú lo cambies
- Drift de datos
- Drift de comportamiento
- Cambios de versión del modelo del proveedor
- Auditoría y trazabilidad
- Gestión de incidentes con agentes
- Versionado: prompts, herramientas y modelos
- Ejemplo: un agente que clasifica y prioriza alertas operativas
- Gobierno: NIST AI RMF e ISO/IEC 42001
- Checklist de AgentOps
- Conversemos
- Preguntas frecuentes
- ¿Qué es AgentOps?
- ¿Qué diferencia hay entre monitorear una API y observar un agente?
- ¿Las convenciones de OpenTelemetry para IA generativa ya son estables?
- ¿Qué es el drift en un agente de IA?
- ¿Qué marcos sirven para gobernar agentes en una organización regulada?
- Fuentes
Poner un agente en producción es el comienzo del trabajo, no el final. A partir de ese día el agente recibe entradas que nadie previó, el proveedor publica nuevas versiones del modelo, los sistemas que consulta cambian de esquema y el costo por tarea se mueve sin que nadie toque el código. Si no puedes ver qué hizo el agente en cada paso, no puedes explicar un error, ni defender una decisión ante auditoría, ni saber si la versión de hoy es mejor que la del mes pasado.
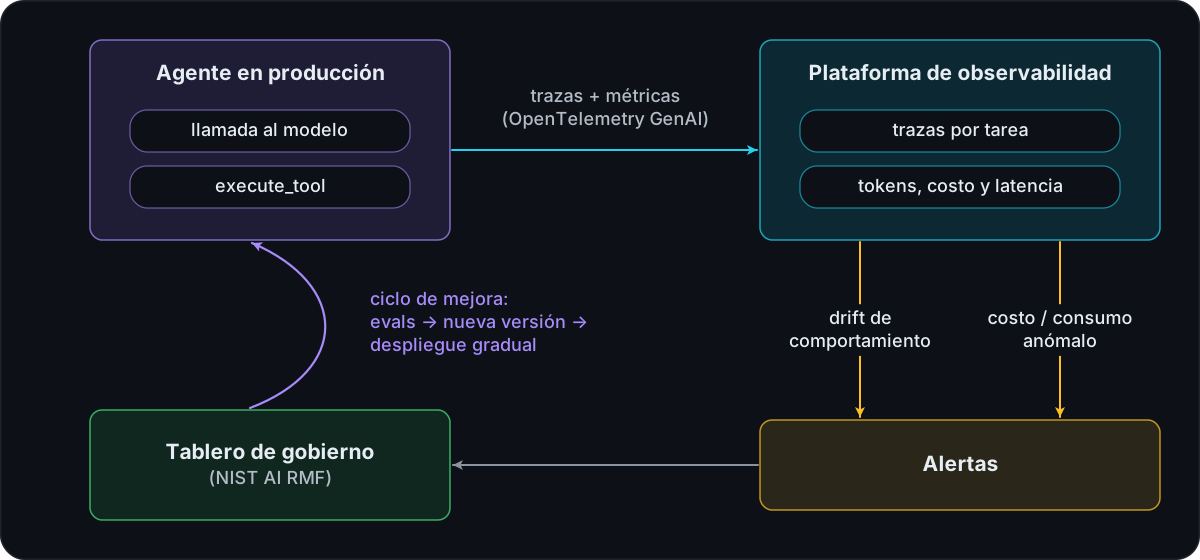
AgentOps es la disciplina que resuelve eso. En el artículo pilar sobre harness engineering la ubicamos en la quinta y la séptima capa del harness: observabilidad y feedback continuo. Aquí bajamos a lo concreto: qué medir, con qué estándar, cómo detectar cambios, cómo auditar, cómo responder a incidentes y cómo gobernar todo el ciclo.
Qué observar en un agente
Un agente no es una API más. Puede devolver una respuesta bien formada, en tiempo y sin errores de red, y aun así haber tomado la decisión equivocada. Por eso la unidad de observación no es la petición, es la traza completa de la tarea.
| Señal | Qué capturar | Para qué sirve |
|---|---|---|
| Traza por paso | Cada llamada al modelo, en orden, con el modelo y la versión usados | Reconstruir el razonamiento y ubicar dónde se desvió |
| Llamadas a herramientas | Nombre, argumentos, resultado, error, duración | Detectar herramientas lentas, mal usadas o que fallan en silencio |
| Tokens y costo | Tokens de entrada y salida por paso, costo por tarea | Presupuestos, alertas de consumo anómalo, comparación entre versiones |
| Latencia | Duración por paso y de punta a punta | Detectar bucles, reintentos y cuellos de botella |
| Escalamientos | Cuándo el agente pidió ayuda humana y qué respondió la persona | Medir autonomía real y calidad de las decisiones |
| Resultado de negocio | Tarea resuelta, revertida, reabierta | Conectar la operación técnica con el valor |
Dos decisiones de diseño importan desde el primer día:
- Correlación. Cada tarea tiene un identificador que viaja por todas las llamadas: modelo, herramientas, sistemas destino y aprobaciones humanas. Sin eso, la traza se rompe justo en el punto que necesitas investigar.
- Contenido versus metadatos. Registrar los prompts y respuestas completos ayuda a depurar, pero puede almacenar datos personales. Separa ambos: metadatos siempre, contenido con retención corta, enmascarado y con acceso restringido.
OpenTelemetry para IA generativa: qué hay y en qué estado está
No hace falta inventar un formato propio de trazas. OpenTelemetry mantiene convenciones semánticas para IA generativa en un repositorio dedicado. Cubren eventos, excepciones, métricas, spans de modelo y spans de agente, además de convenciones específicas para Anthropic, AWS Bedrock, Azure AI Inference, OpenAI y el Model Context Protocol.
Lo relevante para un agente:
- Spans de agente y de herramienta. Operaciones como
invoke_agentyexecute_tool, con atributos comogen_ai.agent.id,gen_ai.agent.versionygen_ai.tool.name. - Uso de tokens y modelo. Atributos como
gen_ai.request.model,gen_ai.response.model,gen_ai.usage.input_tokensygen_ai.usage.output_tokens. - Métricas. Por ejemplo
gen_ai.client.token.usageygen_ai.client.operation.duration. - Contenido como opt-in. Atributos como
gen_ai.input.messagesson opcionales y la propia especificación advierte que probablemente contienen información sensible, incluidos datos personales.
El estado importa: a septiembre de 2026 estas convenciones están marcadas como Development, no como estables. Los nombres de atributos pueden cambiar. La recomendación práctica es adoptarlas, porque te dan portabilidad entre herramientas de observabilidad, pero encapsular la instrumentación en una capa propia para que un cambio de convención no obligue a tocar cada agente.
Detección de drift: cuando el agente cambia sin que tú lo cambies
En un agente hay al menos tres fuentes de drift, y cada una se detecta distinto.
Drift de datos
Los datos que recibe el agente dejan de parecerse a los que había cuando lo evaluaste: un nuevo tipo de solicitud, un proveedor que cambió el formato de sus facturas, un sistema que empezó a devolver campos vacíos. Se detecta vigilando la distribución de entradas (categorías, longitud, idioma, campos faltantes) y la tasa de errores de validación en herramientas.
Drift de comportamiento
Con las mismas entradas, el agente empieza a hacer cosas distintas: más pasos por tarea, más llamadas a una herramienta concreta, más escalamientos, respuestas más largas o más rechazos del revisor humano. Se detecta comparando esas métricas contra una línea base por versión y corriendo, de forma periódica, el mismo conjunto fijo de casos de evaluación y verificación que usaste para aprobar la versión.
Cambios de versión del modelo del proveedor
Es el drift que más sorprende a los equipos, porque no está en su repositorio. Los proveedores retiran modelos con reglas propias:
- Anthropic avisa con al menos 60 días antes de retirar un modelo público, y las peticiones a un modelo retirado fallan.
- En Amazon Bedrock, los modelos pasan por los estados Active, Legacy y End-of-Life; para los lanzados desde el 7 de septiembre de 2026 el periodo Legacy es de 6 meses o de 45 días según el modelo, y la migración no ocurre de forma automática.
- En Azure OpenAI (Microsoft Foundry), los despliegues Standard pueden actualizarse de versión automáticamente; la propiedad
versionUpgradeOptionpermite elegir entre actualizar cuando hay una nueva versión por defecto, solo al vencer la actual o nunca (NoAutoUpgrade).
La lección: fija versiones explícitas del modelo, desactiva las actualizaciones automáticas en producción (en Azure, con NoAutoUpgrade el despliegue deja de funcionar cuando se retira el modelo, así que la migración debe estar planificada antes de esa fecha), registra la versión en cada span y trata cualquier cambio de modelo como un despliegue, con evaluaciones previas y salida gradual. Un calendario de retiros de modelos por proveedor es parte del inventario de AgentOps.
Auditoría y trazabilidad
En una organización regulada, la pregunta de auditoría no es "¿qué dijo el modelo?", sino quién hizo qué, cuándo y con qué permiso. Un registro auditable de un agente responde:
- Quién: el agente (identificador y versión) y el usuario en cuyo nombre actuó.
- Qué: la acción ejecutada, los argumentos y el resultado, con el diff sobre el sistema destino.
- Cuándo: marca de tiempo de cada paso, no solo del inicio de la tarea.
- Con qué permiso: la credencial o el alcance usado y, si hubo aprobación humana, quién aprobó y cuándo.
- Con qué configuración: versión del prompt, del conjunto de herramientas y del modelo.
La especificación de MCP recomienda que los clientes registren el uso de herramientas para auditoría. En la práctica, ese registro debe ser inmutable (solo escritura), tener retención definida por cumplimiento y ser consultable por alguien que no sea el equipo que construyó el agente.
Gestión de incidentes con agentes
Un incidente con un agente se parece a uno de software y a uno operativo a la vez. Conviene tener un runbook específico:
- Contener. Bajar la acción afectada a un nivel de menor autonomía (de ejecutar a sugerir) o desactivar una herramienta concreta, sin apagar todo el agente. Esto solo es posible si el diseño lo previó; lo explicamos en el artículo sobre guardrails y control humano.
- Delimitar. Con las trazas, identificar qué tareas se vieron afectadas, desde cuándo y con qué versión.
- Revertir. Deshacer las acciones que se puedan revertir y abrir casos manuales para las que no.
- Explicar. Reconstruir la cadena: entrada, pasos del modelo, llamadas a herramientas, resultado.
- Prevenir. Convertir el caso en una prueba de regresión que corra antes de cada nueva versión.
Los incidentes de costo merecen mención propia: un bucle de reintentos o una entrada diseñada para inflar el consumo pueden multiplicar el gasto en horas. OWASP recoge ese riesgo como consumo no acotado en su Top 10 for LLM Applications. Las alertas de costo por tarea y por agente, con corte automático, son parte del runbook.
Versionado: prompts, herramientas y modelos
El comportamiento de un agente depende de al menos tres artefactos que cambian a ritmos distintos. Cada uno necesita versión propia, y la combinación necesita una versión del agente:
| Artefacto | Qué versionar | Error típico |
|---|---|---|
| Prompts e instrucciones | Texto, plantillas, ejemplos | Editarlos en caliente desde una consola sin registro |
| Herramientas | Esquema, descripción, permisos, implementación | Cambiar la descripción de una herramienta sin pensar que el modelo la lee |
| Modelo | Proveedor, identificador exacto, parámetros | Usar alias que apuntan a la versión más reciente |
| Agente | La combinación de los tres anteriores | No poder decir qué combinación estaba activa el día del incidente |
Cada nueva versión del agente pasa por el mismo camino: evaluación contra el conjunto fijo de casos, comparación con la versión actual, despliegue gradual (un porcentaje del tráfico o un grupo de usuarios) y reversión en un paso si las métricas empeoran.
Ejemplo: un agente que clasifica y prioriza alertas operativas
Pensemos en un agente que ayuda al equipo de operaciones de TI a clasificar y priorizar alertas de monitoreo. Así se ve con AgentOps aplicado:
- Entrada: alertas del sistema de monitoreo. Se tratan como contenido no confiable: pueden incluir texto de logs escrito por cualquier aplicación.
- Herramientas de lectura (autónomas): consultar métricas recientes del servicio, buscar incidentes similares en el historial, leer el runbook del servicio.
- Decisión estructurada: el agente propone severidad, servicio afectado, probable causa, alertas que agrupa como duplicadas y acción sugerida. La salida se valida contra un esquema.
- Acciones con aprobación humana: abrir o escalar un incidente, silenciar alertas duplicadas, ejecutar un paso de remediación del runbook. La persona de guardia ve la propuesta con la evidencia (gráficas, incidentes similares) y aprueba, corrige o rechaza.
- Observabilidad: cada alerta genera una traza con los pasos del modelo, las consultas hechas, la propuesta y la decisión humana.
- Métricas de operación: porcentaje de propuestas aprobadas sin cambios, tiempo desde la alerta hasta la decisión, alertas silenciadas que luego resultaron relevantes (el error más caro) y costo por alerta clasificada y priorizada.
- Drift: si el proveedor del modelo cambia de versión o aparece un nuevo tipo de alerta, sube la tasa de correcciones humanas; esa alerta de comportamiento dispara una revisión antes de que se pierda una alerta real.
Con el tiempo, las métricas dicen qué acciones pueden subir de nivel de autonomía (agrupar duplicados, por ejemplo) y cuáles deben seguir con aprobación (silenciar o remediar).
Gobierno: NIST AI RMF e ISO/IEC 42001
La operación técnica necesita un marco de gobierno que la ordene y la haga auditable. Dos referencias sirven para organizaciones con altos requisitos de cumplimiento:
- NIST AI RMF 1.0, publicado en enero de 2023, organiza la gestión de riesgo de IA en cuatro funciones. Govern cultiva una cultura de gestión de riesgo; Map establece el contexto, propósito e impactos del sistema; Measure analiza, evalúa y monitorea riesgos con métodos cuantitativos y cualitativos; Manage asigna recursos para tratarlos, incluidos respuesta a incidentes y monitoreo continuo. NIST complementó el marco en julio de 2024 con el perfil de IA generativa NIST AI 600-1.
- ISO/IEC 42001:2023 especifica los requisitos para establecer, implementar, mantener y mejorar de forma continua un sistema de gestión de IA. Es certificable, lo que la hace útil cuando un cliente o regulador pide evidencia formal.
Traducido a AgentOps, el mapeo es directo:
| Función NIST | En la operación del agente |
|---|---|
| Govern | Dueños por agente, políticas de autonomía, inventario de agentes y modelos |
| Map | Procesos que toca cada agente, datos que usa, impacto de sus acciones |
| Measure | Trazas, evaluaciones periódicas, métricas de drift, costo y escalamientos |
| Manage | Runbooks de incidentes, reversión de versiones, ajustes de autonomía |
El tablero de gobierno no es un informe trimestral: es una vista viva que muestra, por agente, versión activa, métricas de calidad, costo, incidentes y cambios pendientes de aprobación.
Checklist de AgentOps
- Cada tarea tiene una traza de punta a punta con identificador de correlación.
- La instrumentación sigue las convenciones GenAI de OpenTelemetry, encapsulada en una capa propia.
- El contenido sensible se registra aparte, enmascarado y con retención corta.
- La versión del modelo está fijada y registrada en cada span; hay un calendario de retiros por proveedor.
- Hay líneas base de comportamiento y evaluaciones periódicas sobre un conjunto fijo de casos.
- Hay alertas de costo por tarea y por agente, con corte automático.
- El registro de auditoría responde quién, qué, cuándo y con qué permiso, y es inmutable.
- Existe un runbook de incidentes que permite contener sin apagar todo el agente.
Conversemos
Si ya tienes agentes en producción, o estás por tenerlos, y necesitas verlos, medirlos y gobernarlos con el rigor que exige tu organización, ese es el foco de nuestro servicio de operación y gobierno de agentes (AgentOps). Escríbenos y revisamos juntos qué está pasando hoy dentro de tus agentes.
Preguntas frecuentes
¿Qué es AgentOps?
Es la disciplina de operar agentes de IA en producción: observar lo que hacen paso a paso, controlar su costo, detectar cuándo cambia su comportamiento, responder a incidentes y gobernar sus versiones. Toma prácticas de DevOps y MLOps y las adapta a sistemas que razonan, llaman herramientas y actúan sobre otros sistemas.
¿Qué diferencia hay entre monitorear una API y observar un agente?
En una API basta con latencia, errores y volumen. En un agente necesitas además la traza de cada paso: qué decidió el modelo, qué herramienta llamó con qué argumentos, qué devolvió y cuántos tokens consumió. Un agente puede responder con código 200 y aun así haber tomado una decisión equivocada.
¿Las convenciones de OpenTelemetry para IA generativa ya son estables?
No. A la fecha de este artículo están marcadas con estado Development y se mantienen en un repositorio propio del proyecto OpenTelemetry. Aun así, ya definen spans para invocar agentes y ejecutar herramientas, atributos de uso de tokens y métricas de duración, así que conviene adoptarlas encapsulando la instrumentación para absorber cambios.
¿Qué es el drift en un agente de IA?
Es un cambio en su comportamiento sin que tú hayas cambiado el agente. Puede venir de los datos que recibe, de la forma en que los usuarios lo usan o de una nueva versión del modelo del proveedor. Se detecta comparando métricas de comportamiento contra una línea base y corriendo evaluaciones periódicas sobre un conjunto fijo de casos.
¿Qué marcos sirven para gobernar agentes en una organización regulada?
El NIST AI RMF 1.0 organiza la gestión de riesgo en cuatro funciones: Govern, Map, Measure y Manage. ISO/IEC 42001:2023 especifica los requisitos de un sistema de gestión de IA certificable. Ambos se complementan: el primero ordena el trabajo de riesgo y el segundo lo convierte en un sistema de gestión auditable.
Fuentes
¿Quieres implementar IA en tu empresa?
Agenda un diagnóstico gratuito con nuestro equipo.
Hablar con un experto